我把同一份596行订单交给 GPT-6 Astra 和 Claude Fable 5.1,让它们回答一个很具体的问题:这家店少卖了多少钱,问题主要出在哪个渠道?
回答完还不算结束。它们还得做出一个能打开的中文报表,能切换渠道,能把当前看到的订单导出成 CSV。
这比问一句“谁写代码更强”容易判断。数字对不上,就是没算对;选了广告渠道却导出全店订单,就是没做完。
最后,Fable 5.1 用了约9分54秒,Astra 用了约10分53秒。两边都算对了,也都交出了能操作的页面。
这轮最直观的差别出现在交付细节:Astra 把随渠道切换的解释放进了网页,导出的 CSV 使用中文业务列名;Fable 5.1 的页面更紧凑,导出保留英文字段名。下面从实际文件和操作结果展开。
这份订单,为什么不能直接求和?
数据是专门制作的教学样例,不涉及真实客户或本站经营情况。两边拿到完全相同的订单表、渠道流量表和统计定义,分别在独立目录里工作。
比较区间固定为8月1日至14日、9月1日至14日。净销售额按已付款订单原金额减退款计算,全额退款的订单仍计入已付款订单数。
原始文件里有三类干扰:8行完全重复的导出记录,6行不在比较区间内的订单,以及12行未付款或取消订单。正确处理后,参与计算的是570笔付款订单。
这几类问题都很普通。自己从店铺后台、支付系统或 Excel 整理资料时,经常会遇到。它们的作用是看看 AI 会不会认真读统计定义,而不是看见一列金额就开始加。
我给两边的任务要求相同,包含三份交付物:一份文字分析,一份能逐项核对的数字汇总,一个不依赖网络也能打开的网页。
网页还必须做到:切换渠道后,卡片、图表、明细和导出使用同一范围。没有人工给它们提示答案,也没有在正式运行中追着改需求。
第一关:6000元的下降,两边都找到了
先看最主要的结果。
| 核对项目 | 独立复算结果 | Astra | Fable 5.1 |
|---|
| 8月净销售额 | 57000元 | 57000元 | 57000元 |
| 9月净销售额 | 51000元 | 51000元 | 51000元 |
| 销售差额 | −6000元 | −6000元 | −6000元 |
| 变化率,保留两位小数 | −10.53% | −10.53% | −10.53% |
| 已付款订单 | 300 → 270笔 | 一致 | 一致 |
| 重复 / 区间外 / 未付款排除数 | 8 / 6 / 12行 | 一致 | 一致 |
我还把各渠道的收入、单数、流量和转化率一起复算,总共核对了36个指定数字字段。两边都是36项通过。
这只是本次样例的计算检查,不能换算成模型对所有表格的正确率。但至少在这一步,没有谁需要靠“解释得好听”掩盖错账。
更有用的结果在渠道拆分里:
| 渠道 | 8月净销售额 | 9月净销售额 | 对总差额的影响 |
|---|
| 自然搜索 | 19000元 | 21000元 | 增加2000元 |
| 短视频广告 | 18000元 | 10000元 | 减少8000元 |
| 老客回购 | 20000元 | 20000元 | 没有变化 |
全店少6000元,广告渠道其实少了8000元。自然搜索多出的2000元,抵消了一部分下降。
如果只看总额,很容易给全店统一做促销。拆到这里,后续调查就可以先围绕广告访客展开。两边都找到了这个线索。
第二关:别急着写“广告不行了”
短视频广告的访问次数,两期都是5000;付款订单却从100笔降到了60笔。转化率从2.00%降到1.20%,相差0.80个百分点。
这能说明付款转化下降了,但还不能断定是哪个具体环节出了问题。
我们的数据没有广告素材、落地页、库存和支付错误记录。如果 AI 直接宣布“广告素材疲劳”或“支付系统故障”,就是把一个待查原因写成了事实。
这一步,两边的分析都保持了区别。它们列出了应该继续核查的方向,没有声称从现有订单表里已经找到全部原因。
Astra 还把这段解释放进了报表。切到短视频广告时,页面会同步显示:访问量不变、少了40笔付款、具体业务原因待核查。打开页面的人不用再翻另一份分析文档,能直接看到数字对应的意思。
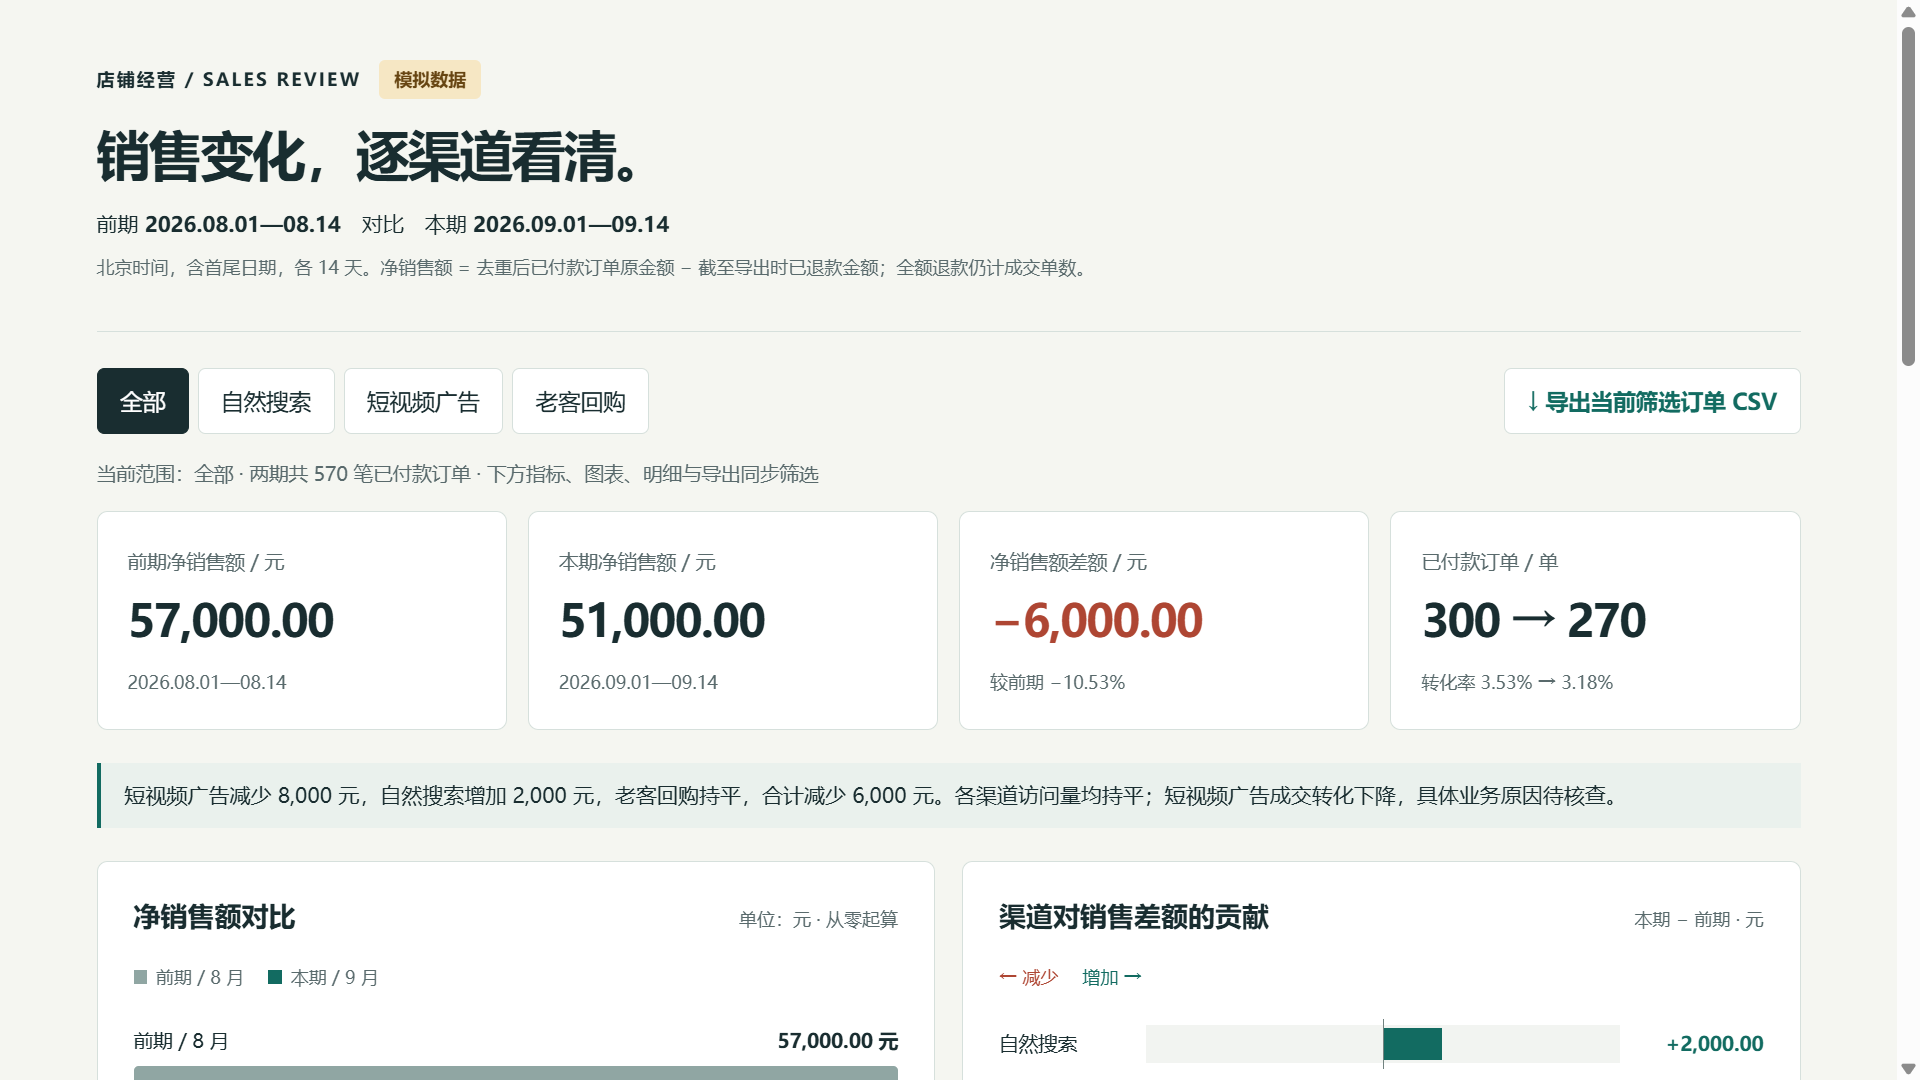
上图是实际生成页面的浏览器截图,使用模拟数据,没有重画界面。
这也是我对 Astra 这版交付比较满意的地方:它把“数字”和“这组数字允许得出的结论”放在了一起。
第三关:页面上的按钮,到底能不能用?
Fable 5.1 做出的报表结构更紧凑。首屏同时放了前后两期收入、差额、变化率、成交单数和转化率;往下就是净销售额对比和各渠道贡献图。
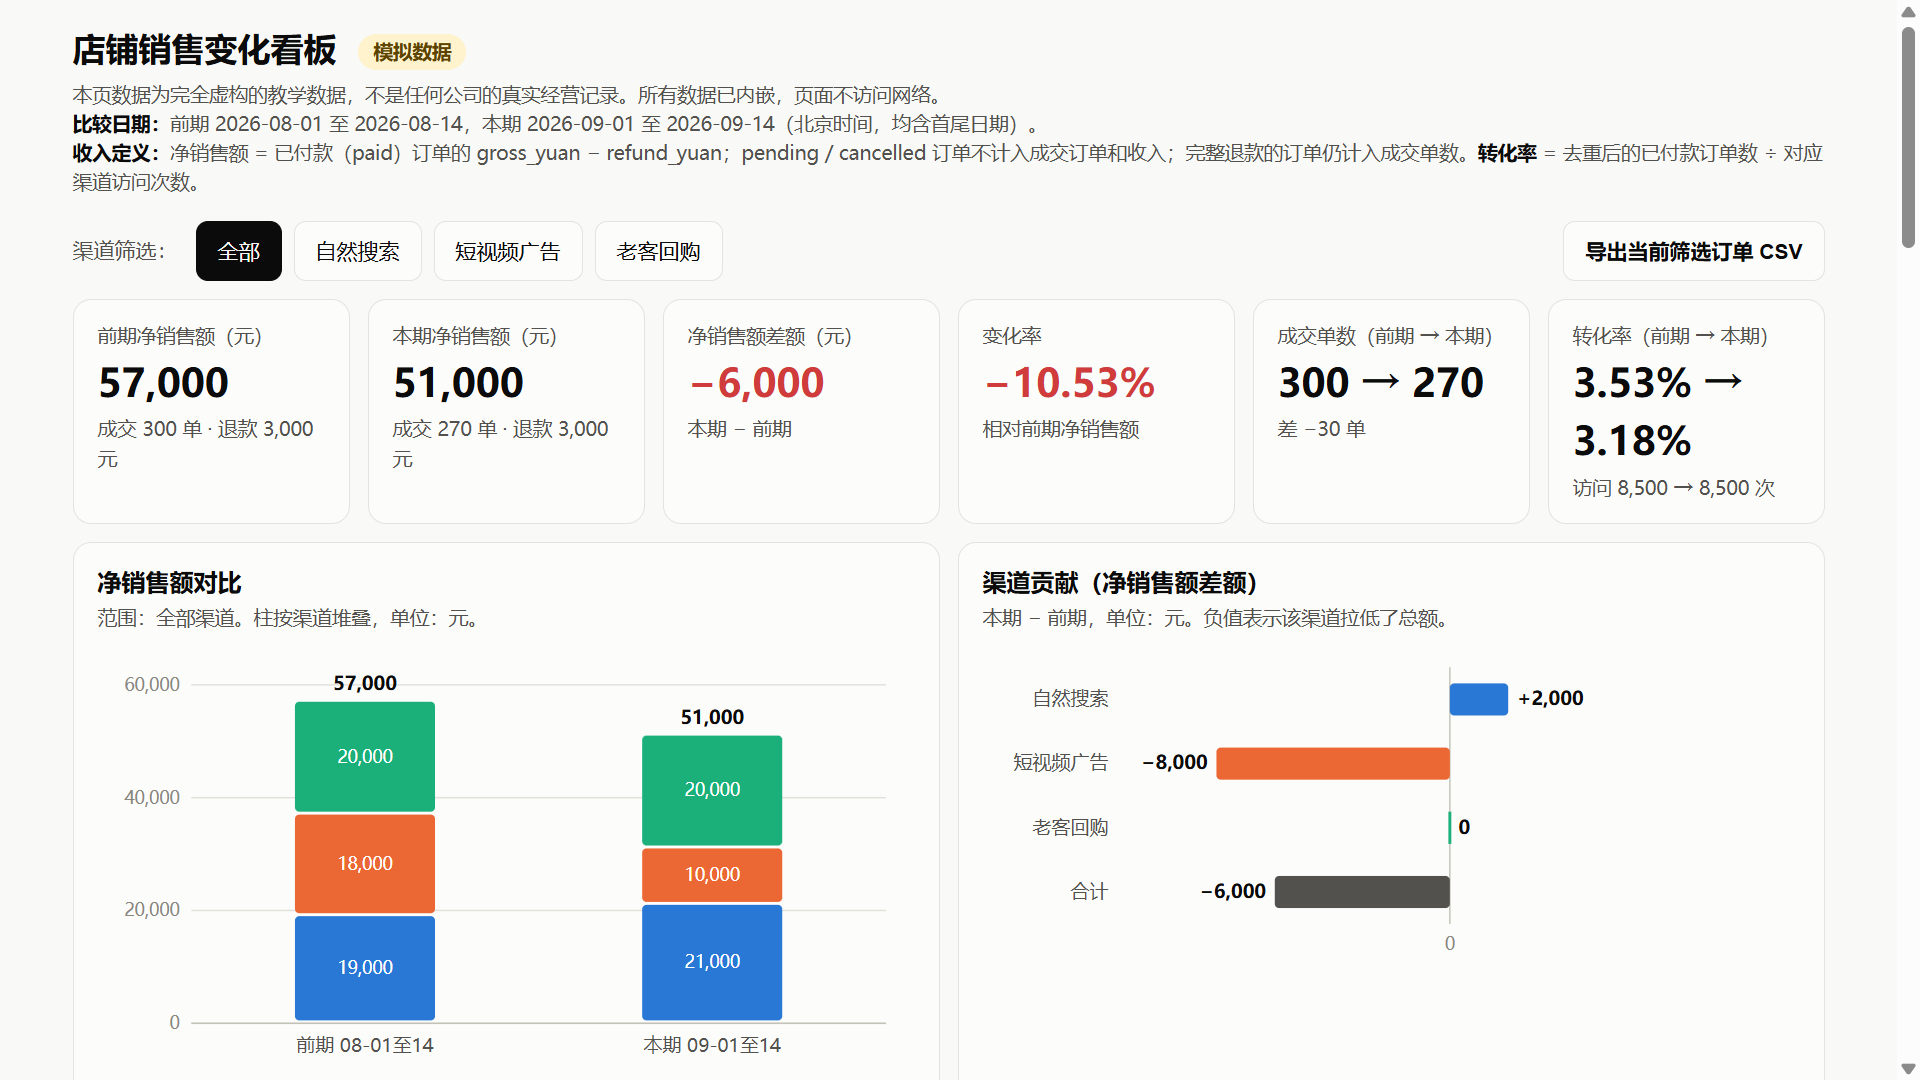
两张截图展示了不同的信息安排:Fable 5.1 在首屏放了更多指标,Astra 在指标下方放了渠道变化的解释。
我实际点了两边的全部、自然搜索、短视频广告和老客回购筛选。对应数字都能切换。
其中最值得单独检查的是短视频广告:选中以后,前期收入应变成18000元,本期10000元,差额−8000元,订单总数变成两期合计160笔。
随后点击“导出当前筛选订单 CSV”,从浏览器下载到本地,再读文件重新求和。
| 实际操作后的检查 | Astra | Fable 5.1 |
|---|
| 筛选短视频广告后卡片切换 | 正确 | 正确 |
| 下载得到160条订单 | 是 | 是 |
| 文件只包含短视频广告 | 是 | 是 |
| 文件内8月净额合计 | 18000元 | 18000元 |
| 文件内9月净额合计 | 10000元 | 10000元 |
| CSV列标题 | 中文业务名称 | 英文字段名 |
最后一行是个很小、但实际能感受到的区别。
Astra 导出的列名是“订单号”“日期(北京时间)”“净销售额(元)”;Fable 5.1 用的是 order_id、order_date、net_yuan 一类字段名。两份数据都正确。Astra 的中文列名能直接对应业务概念;Fable 5.1 保留的英文字段名便于程序识别。
交付差距有时就出现在这些地方。 它不一定改变算题成绩,却会改变你拿到结果以后还要做多少整理。
这一次,Fable 5.1 比 Astra 早结束约59秒
| 本次正式运行 | GPT-6 Astra | Claude Fable 5.1 |
|---|
| 使用工具 | Codex CLI 0.154.0 | Claude Code 2.1.272 |
| 推理设置 | high | high |
| 交付三份文件并结束任务 | 10分53秒 | 9分54秒 |
| 人工补充需求或纠正答案 | 0轮 | 0轮 |
| 指定数字字段核对 | 36 / 36 | 36 / 36 |
| 原始页面的真实筛选与下载 | 通过上述检查 | 通过上述检查 |
这是单个任务的一轮运行,耗时包含模型响应、工具执行和客户端自身检查。不同工具的系统提示词和可用能力也不一样,因此它是实际工具组合的体验对比,不是实验室里剥离一切差异的纯模型测试。
正式运行前,我处理过启动权限问题;那部分记录单独保留,没有混进表里的耗时。以上计时到各工具返回最终结果为止,之后由我独立完成网页操作与下载核对,没有替它们修改报表代码。
验证说明中,Astra 明确说自己没有做真实浏览器测试,Fable 5.1 也把自己的无头截图检查与实际点击下载区分开。它们没有一句“全部验证通过”就把没有做过的事情带过去。
官方跑分,怎样帮助理解这次结果?
有了这份实际任务,再回来看官方分数,就更容易判断哪些能力值得继续考察。
| 官方评测 | 大致考什么 | Astra | Fable 5.1 |
|---|
| AutomationBench | 多步骤业务流程 | 41.4% | 31.4% |
| Terminal-Bench 4.0 | 复杂命令行任务 | 57.9% | 55.8% |
| DeepSWE v1.1 | 现有软件项目中的工程任务 | 74.1% | 67.4% |
| GPQA Diamond | 高难度科学问答 | 96.0% | 93.7% |
| HLE,带工具 | 跨学科难题 | 57.2% | 65.0% |
来源:OpenAI GPT-6 发布页及评测说明。表内是官方公布的成绩,与上面的本地实跑分开看。
Astra 在多步骤业务与软件工程项目上有优势信号,Fable 5.1 在 HLE 带工具项目中领先。我们的订单任务难度有限,两边都通过并不奇怪;一次都能做对的任务,也不足以证明它们在更复杂工作中没有差距。
反过来,官方某项领先,也不能自动变成“今天这份经营报表一定完成得更快”。这轮计时就给出了不同结果。
模型 API 的价格
Astra 与 Fable 5.1 的标准 API 普通输入,均为每百万 token 10美元,输出均为50美元;缓存读取分别为1美元和0.25美元。Astra 超过272K输入涉及长上下文加价。这是按用量调用模型的价格,与下面的个人订阅分开计算。OpenAI API 价格、Anthropic API 价格
GPT 的价格与套餐,包含哪些使用价值?
上面的 API 价格,是开发者按调用量付费的口径。个人使用 ChatGPT 和 Codex,还有按月订阅的方式。
| ChatGPT 套餐 | 官方月费(美元) | Codex 额度档位 | 包含的主要能力 |
|---|
| Plus | 20 | 基础付费额度 | GPT-6 Astra、Codex、文件分析、图片生成、深度研究等 |
| Pro 5X | 100 | Plus 的5倍 | Plus 能力,以及 Pro 推理模型等进阶功能 |
| Pro 20X | 200 | Plus 的20倍 | 与 Pro 5X 相同的核心能力,更高使用额度 |
来源:Codex 官方价格说明、ChatGPT 套餐功能、Pro 两档说明。价格为官网美元月费,税费与地区结算以官方页面为准。5X、20X描述使用额度,不代表每个任务的速度或效果倍数。
一份订阅可以覆盖多种工作。 这次做订单报表用到了 Codex;同一账号还可以处理文档、生成配图、进行深度研究。对于既做表格又写内容、偶尔还要做页面的人,套餐的价值包含这一整组工具,而不只是某一个模型的单次回答。
包含额度内的月度支出更容易安排。 日常在 ChatGPT 和 Codex 的订阅额度内使用,不需要每次按 API 输入、输出另付一次费用;额度用尽后可等待恢复,或按官方提供的方式购买额外 credits。订阅有使用限制,API 账单则单独计算。
套餐之间主要通过额度区分工作量。 Pro 5X 与 Pro 20X 的核心能力相同,差别在于能使用多少。比如同样要反复调整报表、处理多份文件,较高额度为这些连续任务提供了更多使用空间。
截至2026年9月15日,官方暂时停止 Pro 20X 的新订阅与升级,已有 Pro 20X 续费以及 Pro 5X 不受这次暂停影响。当前开通状态
PayForChat 的人民币价格、当前可售套餐和充值服务见 套餐页。PayForChat 为独立第三方服务,模型功能及额度由 OpenAI 提供。
延伸阅读:Codex 使用指南、GPT-6 提示词与 Skills 设置。
2026-09-15:加入同数据、同任务的本地实跑,保留原始交付文件与日志;新增真实浏览器截图及独立数字、下载核验。